

Le robots.txt et le sitemap XML sont deux petits fichiers techniques que la plupart des visiteurs ne verront jamais. Pourtant, ils jouent un rôle important dans la relation entre votre site et Google. Le premier indique aux robots ce qu'ils peuvent explorer, le second leur présente la liste des pages à connaître. Mal configurés, ils peuvent empêcher des pages importantes d'apparaître dans les résultats. Voici comment ils fonctionnent, comment les vérifier et quelles erreurs éviter.
Exploration et indexation : deux étapes différentes
Pour bien comprendre ces fichiers, il faut distinguer deux étapes. L'exploration, c'est le moment où le robot de Google parcourt votre site et lit vos pages. L'indexation, c'est le moment où Google décide d'enregistrer une page dans son index pour pouvoir l'afficher dans les résultats.
Le robots.txt agit sur l'exploration. Le sitemap aide à la découverte des pages. Aucun des deux ne garantit à lui seul qu'une page sera indexée ou au contraire exclue des résultats. Cette nuance explique beaucoup d'erreurs courantes.
Le fichier robots.txt
Ce qu'il fait
Le robots.txt est un simple fichier texte placé à la racine du site, accessible à une adresse du type votresite.fr/robots.txt. Il contient des règles qui indiquent aux robots des moteurs de recherche quelles parties du site ils peuvent explorer ou non.
Une règle se compose généralement de deux éléments : le robot concerné, avec la ligne User-agent, et les dossiers ou pages à ne pas explorer, avec la ligne Disallow. Sur un site WordPress, on trouve par exemple souvent une règle qui bloque l'exploration de l'espace d'administration, tout en autorisant un fichier technique nécessaire au bon fonctionnement de certaines pages.
Ce qu'il ne fait pas
Le robots.txt n'est pas un moyen fiable d'empêcher une page d'apparaître dans Google. Une page bloquée peut tout de même être indexée si d'autres sites font des liens vers elle. Elle s'affiche alors parfois dans les résultats sans description, puisque Google n'a pas pu la lire.
Pour exclure une page des résultats, la bonne méthode est la balise noindex, placée dans la page elle-même. Attention au piège : si cette page est aussi bloquée dans le robots.txt, Google ne peut pas l'explorer et ne verra donc jamais la balise noindex. Les deux méthodes ne doivent pas être combinées sur une même page.
Le robots.txt n'est pas non plus un outil de sécurité. Il est lisible par n'importe qui. Un contenu confidentiel doit être protégé par un mot de passe, pas par une règle d'exclusion.
L'erreur à éviter absolument
La règle « Disallow: / » bloque l'exploration de tout le site. Elle est parfois ajoutée pendant le développement d'un site, puis oubliée au moment de la mise en ligne. C'est l'une des causes classiques d'un site qui n'apparaît pas sur Google. Sur WordPress, vérifiez aussi la case « Demander aux moteurs de recherche de ne pas indexer ce site » dans les réglages de lecture : elle doit être décochée sur un site en ligne.
Le sitemap XML
Ce qu'il fait
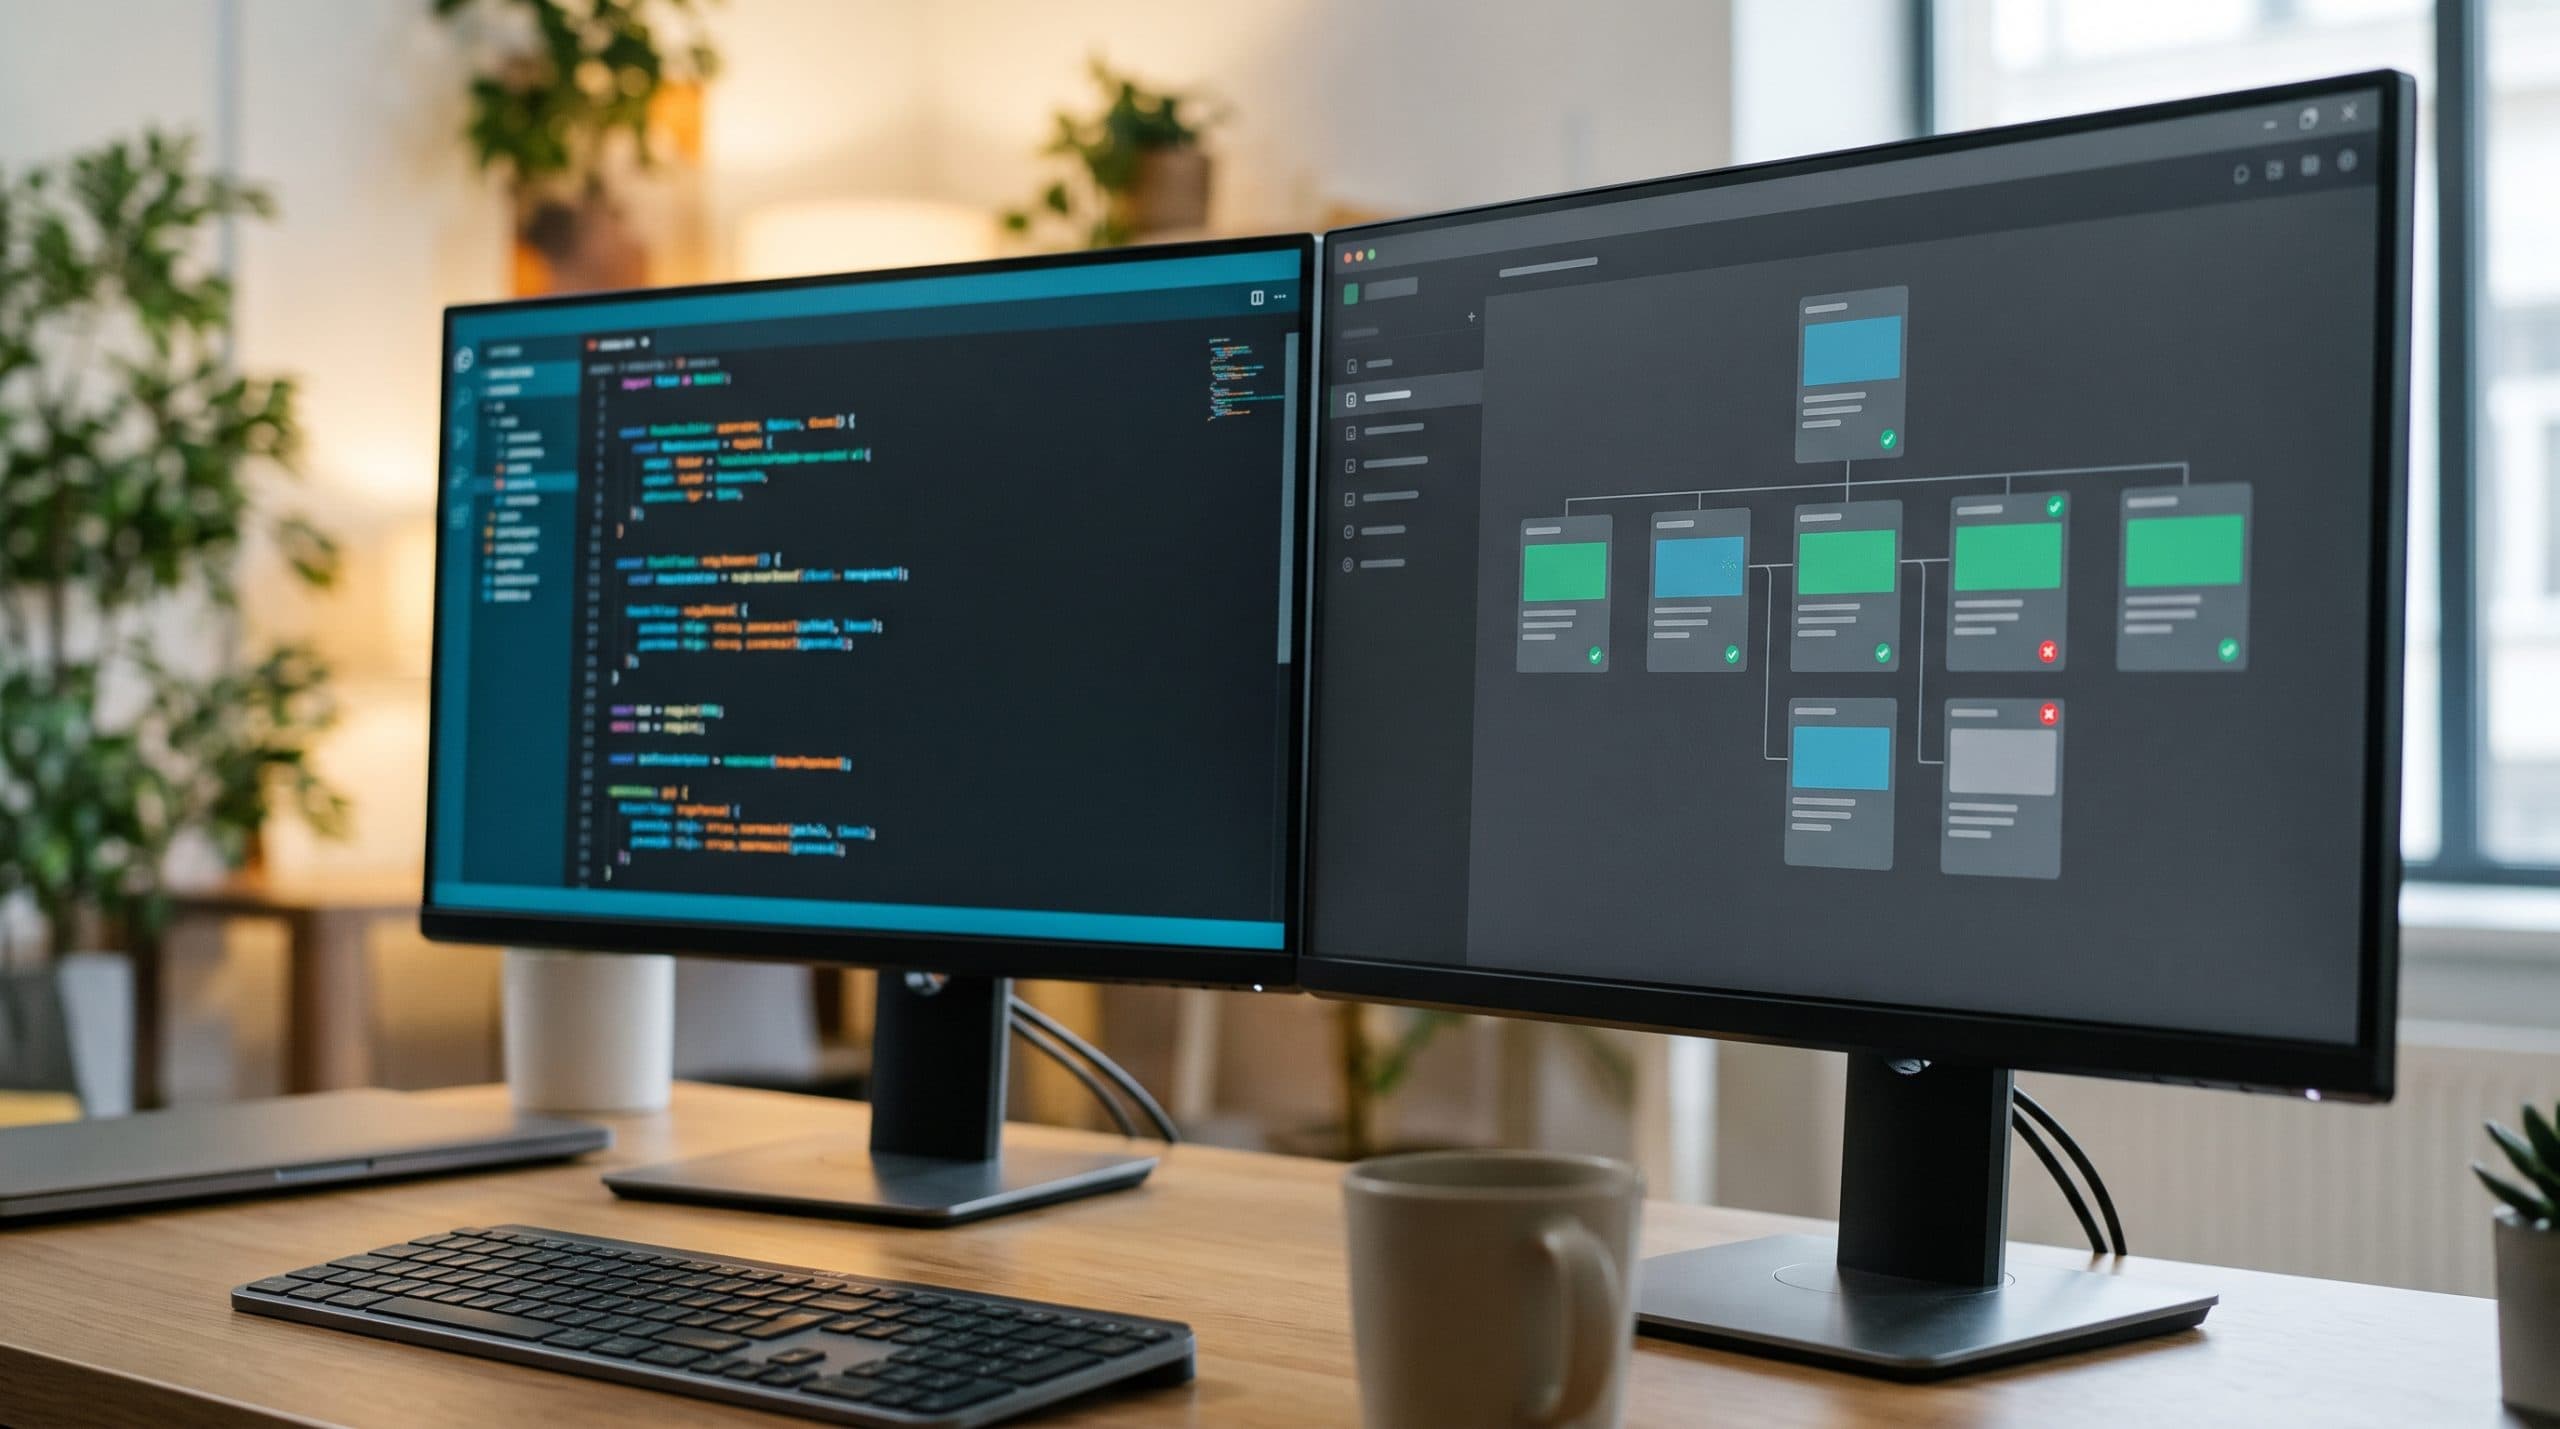
Le sitemap XML est un fichier qui liste les adresses des pages que vous souhaitez voir explorées et indexées. Il aide Google à découvrir vos contenus, notamment les pages récentes ou peu reliées au reste du site. Il peut aussi indiquer la date de dernière modification de chaque page.
Pour un petit site bien structuré, Google trouverait de toute façon la plupart des pages en suivant les liens internes. Le sitemap reste toutefois utile pour accélérer la découverte des nouveautés et pour suivre l'indexation dans la Search Console.
Comment l'obtenir sur WordPress
Depuis plusieurs années, WordPress génère automatiquement un sitemap de base. La plupart des extensions SEO le remplacent par leur propre version, souvent plus complète et mieux paramétrable. Dans ce cas, un seul sitemap doit être actif. Vérifiez dans les réglages de votre extension quelle adresse elle utilise.
Le sitemap principal prend souvent la forme d'un index qui regroupe plusieurs sitemaps secondaires : un pour les pages, un pour les articles, un pour les produits sur une boutique en ligne. C'est normal.
Ce qu'il doit contenir
Un bon sitemap ne contient que les pages utiles, accessibles et que vous souhaitez voir dans Google. Il ne doit pas inclure :
- des pages redirigées vers une autre adresse ;
- des pages en erreur ou supprimées ;
- des pages marquées en noindex ;
- des doublons, comme des versions avec paramètres d'une même page.
Un sitemap rempli d'adresses inutiles envoie des signaux contradictoires. Une boutique en ligne qui a retiré des produits de son catalogue doit vérifier qu'ils ont bien disparu du sitemap.
Certains réglages anciens, comme la priorité ou la fréquence de modification indiquées pour chaque page, sont ignorés par Google. La date de dernière modification, en revanche, peut être prise en compte si elle est exacte.
Relier les deux fichiers à la Search Console
Une fois le sitemap prêt, soumettez son adresse dans la section Sitemaps de la Search Console. L'outil indiquera s'il a pu le lire et combien de pages il y a trouvées. Vous pouvez aussi mentionner l'adresse du sitemap dans le robots.txt, avec une ligne « Sitemap: » suivie de l'adresse complète.
La Search Console propose également un rapport consacré au robots.txt. Il montre le fichier que Google a récupéré, la date de la dernière lecture et les éventuelles erreurs. Après chaque modification importante, jetez-y un œil.
Les moments où il faut vérifier
Ces fichiers se configurent une fois, puis se font oublier. Certains moments imposent pourtant une vérification. Lors d'une refonte de site, assurez-vous que le robots.txt du site de développement n'a pas été copié sur le site en ligne et que le nouveau sitemap reflète les nouvelles adresses. Après l'installation ou le changement d'une extension SEO, vérifiez qu'un seul sitemap est actif. Pendant une phase de test, protégez la copie du site par un mot de passe plutôt que par le seul robots.txt, une précaution qui fait partie d'une bonne maintenance WordPress.
Un contrôle de ces deux fichiers fait aussi partie de tout audit SEO sérieux.
Conclusion
Le robots.txt guide l'exploration de votre site, le sitemap XML aide Google à découvrir vos pages. Aucun des deux ne décide seul de l'indexation, mais une erreur dans l'un ou l'autre peut rendre des pages invisibles. Gardez un robots.txt simple, n'y bloquez jamais vos pages importantes, utilisez la balise noindex pour exclure une page des résultats et maintenez un sitemap propre, limité aux pages utiles. Quelques vérifications dans la Search Console suffisent ensuite à garder l'ensemble sous contrôle.
FAQ sur le robots.txt et le sitemap XML
Mon site a-t-il besoin d'un robots.txt ?
Ce n'est pas obligatoire. Sans fichier robots.txt, Google considère qu'il peut explorer tout le site. Sur WordPress, un fichier de base est généralement généré automatiquement.
Comment empêcher une page d'apparaître dans Google ?
Utilisez la balise noindex dans la page, sans la bloquer dans le robots.txt, afin que Google puisse lire cette instruction. Pour un contenu confidentiel, protégez-le par un mot de passe.
Où trouver l'adresse de mon sitemap ?
Elle est indiquée dans les réglages de votre extension SEO. Elle figure aussi souvent dans votre fichier robots.txt, sur une ligne commençant par « Sitemap: ».
Une page présente dans le sitemap sera-t-elle forcément indexée ?
Non. Le sitemap aide Google à découvrir la page, mais il décide ensuite de l'indexer ou non selon sa qualité et son utilité.